Historian v8.2 maakte het platform makkelijker om op aan te sluiten. v8.3, vandaag uitgebracht, maakt je data betrouwbaarder. De release brengt referentiewaarden samen op één plek, laat zien wanneer een datastroom stilvalt en maakt berekeningen goedkoper om uit te voeren. Lees hier de changelog of lees verder.
De meeste dataproblemen in een fabriek zijn stil. Een limiet wordt in sommige berekeningen aangepast, maar niet in andere. Een datastroom valt 's nachts stil. Eén berekening neemt langzaam de server over. Elk van die problemen maakt de cijfers een beetje minder betrouwbaar. Historian v8.3 pakt ze alle drie aan.
Voor wie dit is, en waarom het telt
Deze release is voor de mensen die fabrieken draaien en hun data aan het werk houden: productiemanagers, automatiseringsingenieurs en de IT- of data-eigenaars die de historian beheren. Ze past bij voeding en dranken, bouwmaterialen, en fijnchemie en specialty chemicals, waar een verkeerd setpoint of een onopgemerkt gat in de data kan leiden tot uitval, stilstand of een mislukte audit.
Recepten en productkwaliteiten
Producten, recepten en kwaliteiten zijn vaak gekoppeld aan een set eigenschappen, zoals doeltemperaturen of buigtijden. Veel teams bewaren die koppeling in een aparte database of via omwegen in measurements. Met opzoektabellen bewaar je de koppeling in Historian en lees je ze rechtstreeks uit in je berekeningen.
Machinelimieten en setpoints
Wanneer een temperatuur- of druklimiet verandert, moet elke berekening die ze gebruikt worden aangepast. Staat er ook een kopie in een Excel-lijst, dan lopen de kopieën uit elkaar, en de fout kan maandenlang onopgemerkt blijven. Opzoektabellen houden de waarde op één plek, zodat één wijziging elke berekening bereikt die ze gebruikt.
Teams die overstappen van een andere historian
Teams die overstappen van een andere historian, gebruiken vaak opzoektabellen voor receptdata en koppelingen tussen kwaliteit en eigenschappen, en die data moet na de overstap blijven werken. Met opzoektabellen breng je ze naar Historian en gebruik je ze in je berekeningen.
Stilgevallen datastromen
Een datastroom die niet meer bijwerkt, kan een dashboard urenlang de laatste goede waarde laten tonen. De kolom Last value toont de nieuwste waarde van elke measurement, zodat een stilgevallen datastroom opvalt zonder dat je elke measurement apart hoeft te openen.
Zware berekeningen op een gedeelde server
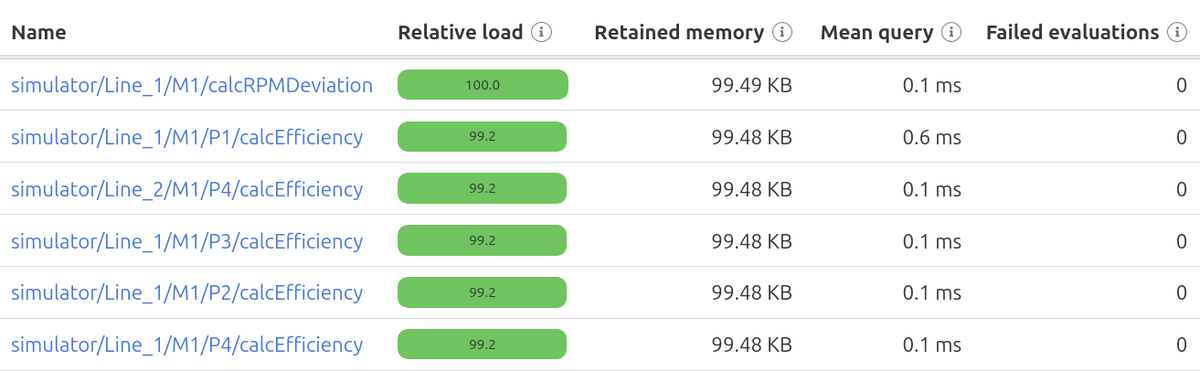
Naarmate meer berekeningen op dezelfde server draaien, kunnen trage berekeningen ongemerkt capaciteit van de rest afnemen. Het overzicht van de berekeningsbelasting toont welke berekeningen het meest kosten, en een lager geheugengebruik bij veel berekeningen laat meer ruimte op dezelfde server.
Opzoektabellen: referentiedata op één plek
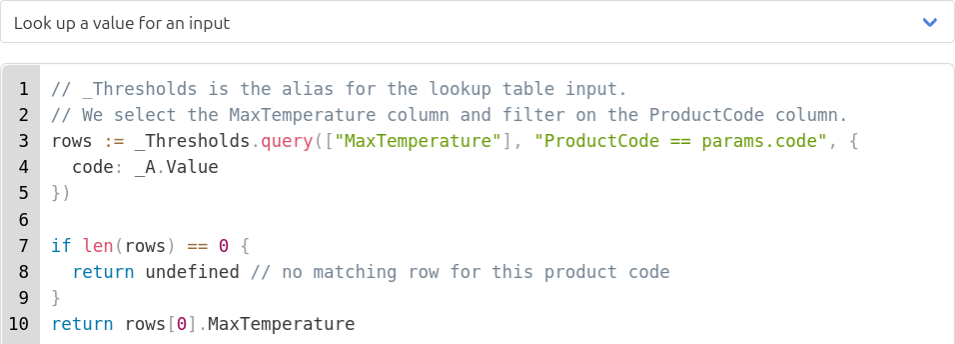
Opzoektabellen bewaren gedeelde waarden in één getypeerde tabel op de nieuwe pagina Opzoektabellen. Berekeningen en berekende eventeigenschappen kunnen de tabel lezen en de rijen filteren, zodat één wijziging elke berekening bereikt die de waarde gebruikt. Bewaar bijvoorbeeld een specificatielimiet per productcode in één tabel: pas de limiet één keer aan, en elke berekening voor dat product volgt.
- Importeer uit xlsx of csv, en exporteer de tabel naar Excel
- Kolommen hebben het type String, Number of Boolean
Voor het aanmaken of wijzigen van tabellen is de licentiefunctie voor opzoektabellen nodig. De toegang wordt geregeld met de rechten READ_LOOKUP_TABLES en MANAGE_LOOKUP_TABLES.

Zie stilgevallen datastromen op tijd
Een datastroom die niet meer bijwerkt, mis je makkelijk. De nieuwe kolom Last value toont de nieuwste waarde van elke measurement, met tijdstempel, zodat een stilgevallen datastroom opvalt zonder dat je elke measurement apart hoeft te openen.
Zie wat elke berekening kost
Het nieuwe overzicht van de berekeningsbelasting toont wat elke berekening kost. Gebruik het om de berekeningen te vinden die de server vertragen, voordat ze een probleem worden. Ook het geheugengebruik ligt lager wanneer veel berekeningen tegelijk draaien.
Gebouwd om snel te blijven bij groei
v8.3 pakt de onderdelen van het systeem aan die vertragen op grote databases:
| Wijziging | Wat het doet |
|---|---|
| Eventfiltering | Events filteren op een eigenschapswaarde gaat sneller op grote databases. |
| SQL-views voor events | De SQL-views per eventtype laden sneller op grote databases. |
| Querycache | Queries kunnen uit het geheugen worden beantwoord wanneer de cache het gevraagde bereik dekt. |
| Periodieke eventeigenschappen | Berekende eventeigenschappen kunnen nu periodiek zijn. |
| Child-events | Configuraties voor child-events krijgen de instellingen parent window en wait for parent. |
Voordat je upgradet
Sommige wijzigingen vragen actie voordat je bijwerkt. Lees deze eerst.
- event_name hernoemen: De upgrade start niet zolang een eventtype een eigenschap met de naam event_name heeft. Hernoem die eerst.
- Views op eventeigenschappen: event_properties wordt een alleen-lezen view. Rechtstreekse SQL-schrijfacties werken niet meer, en eigen views erop moeten opnieuw worden aangemaakt.
- Schijfruimte: De nieuwe tabel voor eventeigenschappen heeft 5 tot 6 keer zoveel schijfruimte nodig als de oude. De backfill kan even duren.
- Berekeningsscripts: Om een berekeningsscript op te slaan of uit te voeren is het recht READ_LOOKUP_TABLES nodig.
- REST API: Sleutels in JSON-bodies zijn nu hoofdlettergevoelig, en request bodies zijn beperkt tot 64 MB.
Nog steeds dezelfde Historian, nog steeds in beweging
v8.3 draait erom dat de data die je al verzamelt makkelijker te beheren en te vertrouwen is. De volledige lijst met wijzigingen, inclusief de upgradedetails, staat in de release notes.